
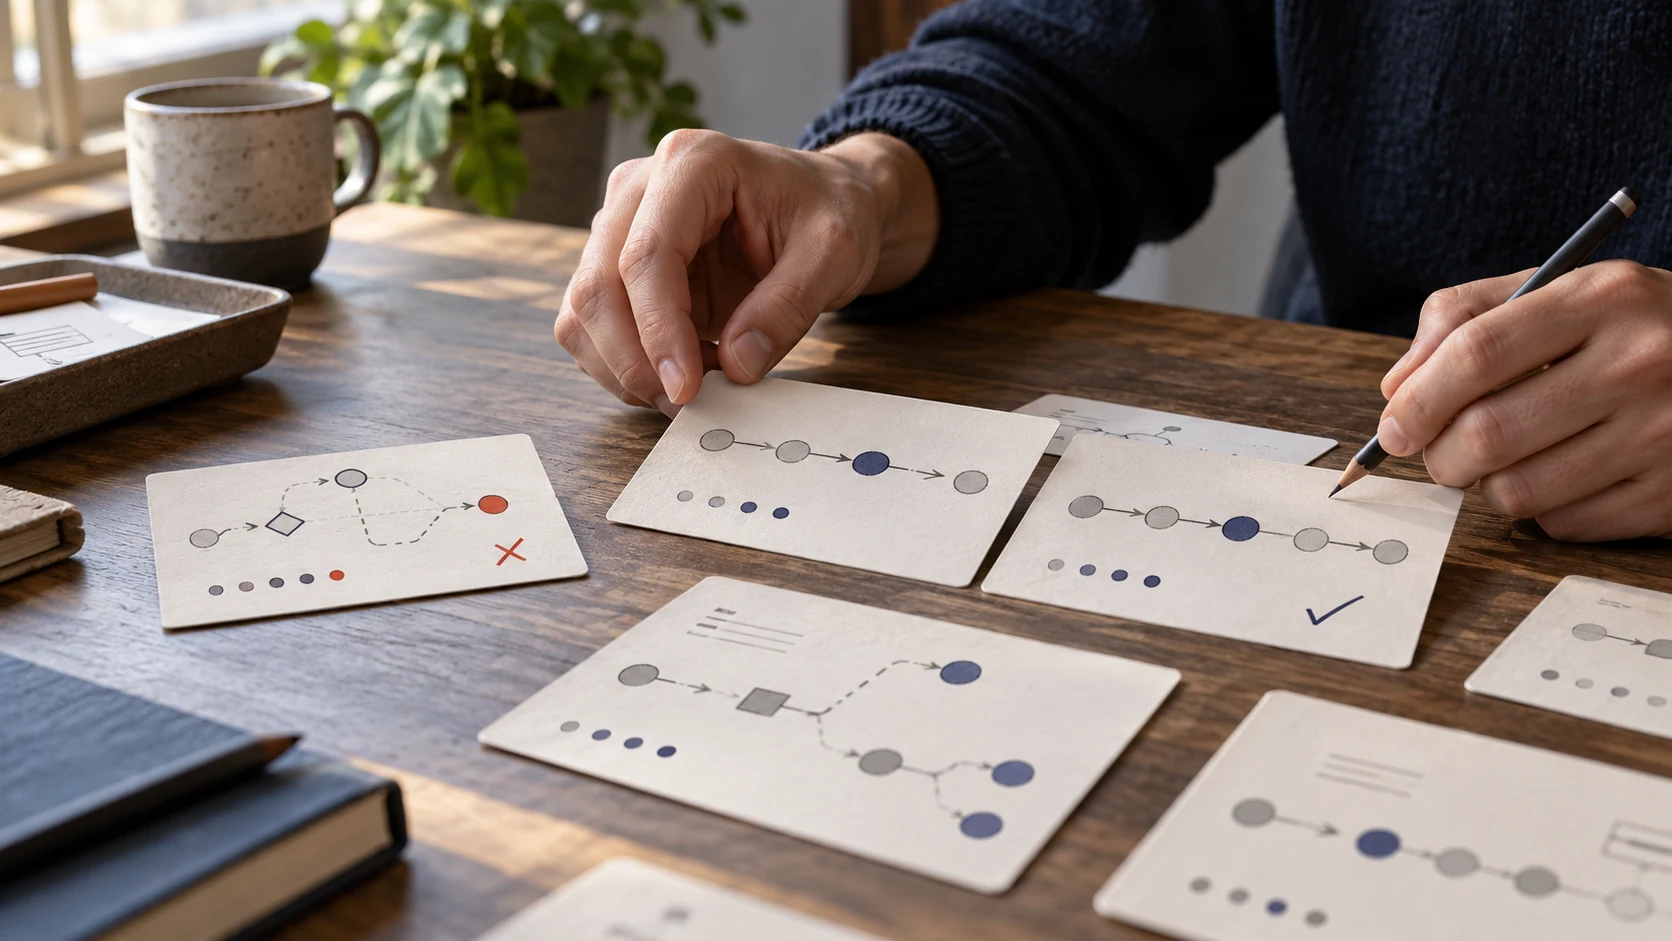
Agent 的评测集,最容易走偏的地方是把每道题都写成“问句加标准答案”。对知识问答,这样还能检查措辞和依据;对要调用工具、读取状态、等待确认的业务任务,答案写得漂亮不代表任务做对了。评测样本需要描述任务终点,也要记录什么动作被允许、什么副作用不该发生,以及遇到不确定状态时系统应如何停下来。
从真实业务任务抽样,不直接搬运生产日志
样本来源可以包括业务人员整理的任务、经过授权和脱敏的客服或操作记录、试点期间的人工接管事件,以及上线验收中发现的边界问题。原始日志可能带有个人信息、客户机密和偶然上下文,进入测试集前应按组织政策筛选和处理;保留评测所需的语义与状态,去掉没有必要的身份和敏感字段。
采样时要按任务类型分层,而不是只挑最常见的问题。比如知识查询、条件筛选、表单草稿、跨系统核验各自需要不同的预期结果;缺字段、口径冲突、权限不足、接口部分失败和用户取消也应成为独立样本。否则高频简单用例会挤掉少见但后果更重的错误路径。
每条用例记录任务目标和可接受结果
一个可维护的用例可以包含:脱敏后的用户请求、必要的业务状态、当前用户的授权范围、预期结果、允许使用的工具,以及禁止发生的副作用。对于开放式任务,还可以写明可以接受的结果范围和必须引用的依据;对于有明确状态转换的任务,则要直接核对业务系统最终状态,而不只判断 Agent 说自己完成了。
工具轨迹也不一定只有唯一正确顺序。如果同一任务允许先查订单再看物流,也允许先确认物流再回查订单,评测应表达必要动作和禁用动作,而不是要求逐字逐步复现某条轨迹。只有在流程规则本身要求固定顺序时,才把次序作为硬性条件。Google Cloud 的 Agent 评测资料展示了把输入、期望轨迹、实际轨迹和最终回答纳入评估的思路;实际字段和指标仍要根据企业任务调整。
失败样本要写出判定理由
故障日志只有变成可复用的用例,才会对下一版本有帮助。每个失败样本都应标注为什么失败:资料版本不对、检索漏掉关键证据、调用了不合适的工具、参数不符合规则、权限校验缺失,还是异常后没有安全退出。修复后将原样本加入回归,同时补一两个相邻边界条件,避免只把单个例子修到通过。
评测应分别观察最终结果、依据质量、工具选择与参数、权限和安全要求、耗时及调用成本。总分可以帮助比较版本,但越权读取、未经确认的写入等关键约束不适合被其他高分抵消,应作为单独的阻断项。具体阈值需要依据业务风险、历史基线和人工检查来定,不宜在没有样本和基线时先编一个行业通用百分比。
数据、评测器和系统版本要一起留档
同一评测集要能在不同版本重复运行。记录样本集版本、模型与提示词版本、知识快照、工具契约和运行环境,才能分辨变化来自哪里。人工评审适合校准开放式质量和高风险案例;模型评审可以辅助扩大筛查,但要先用人工样本检查其稳定性,不能把自动打分当作不可质疑的真值。
当知识、模型、提示词、检索参数或业务接口发生变化时,按影响范围运行回归;失败结果要能关联到负责团队和修复版本。评测报告除了通过与未通过,也应保留具体样本、轨迹和错误说明。这样研发人员可以判断是修复引入了回归,还是新数据揭示了以前没有覆盖的任务边界。
让评测集随业务变化,但不随意漂移
用例需要持续吸收真实问题,也要保留一组稳定的基准样本用于版本对比。新增样本要注明来源、脱敏状态、审核人和适用的规则版本;不再有效的用例则标记原因,不直接删除历史记录。宜天信达可在企业 Agent 开发和运维过程中,协助业务、IT 与安全团队共同整理评测样本、任务边界和回归结果,让评测集成为持续改进的工程资产。
延伸阅读
Google Cloud:Evaluate agents using the GenAI Client in Vertex AI SDK;Google Cloud:Evaluation package。
 本地大模型、部署选型
 企业 Agent、上线验收
 企业 Agent、MCP 接入
 本地模型、安装验收
 制造业设备运维