
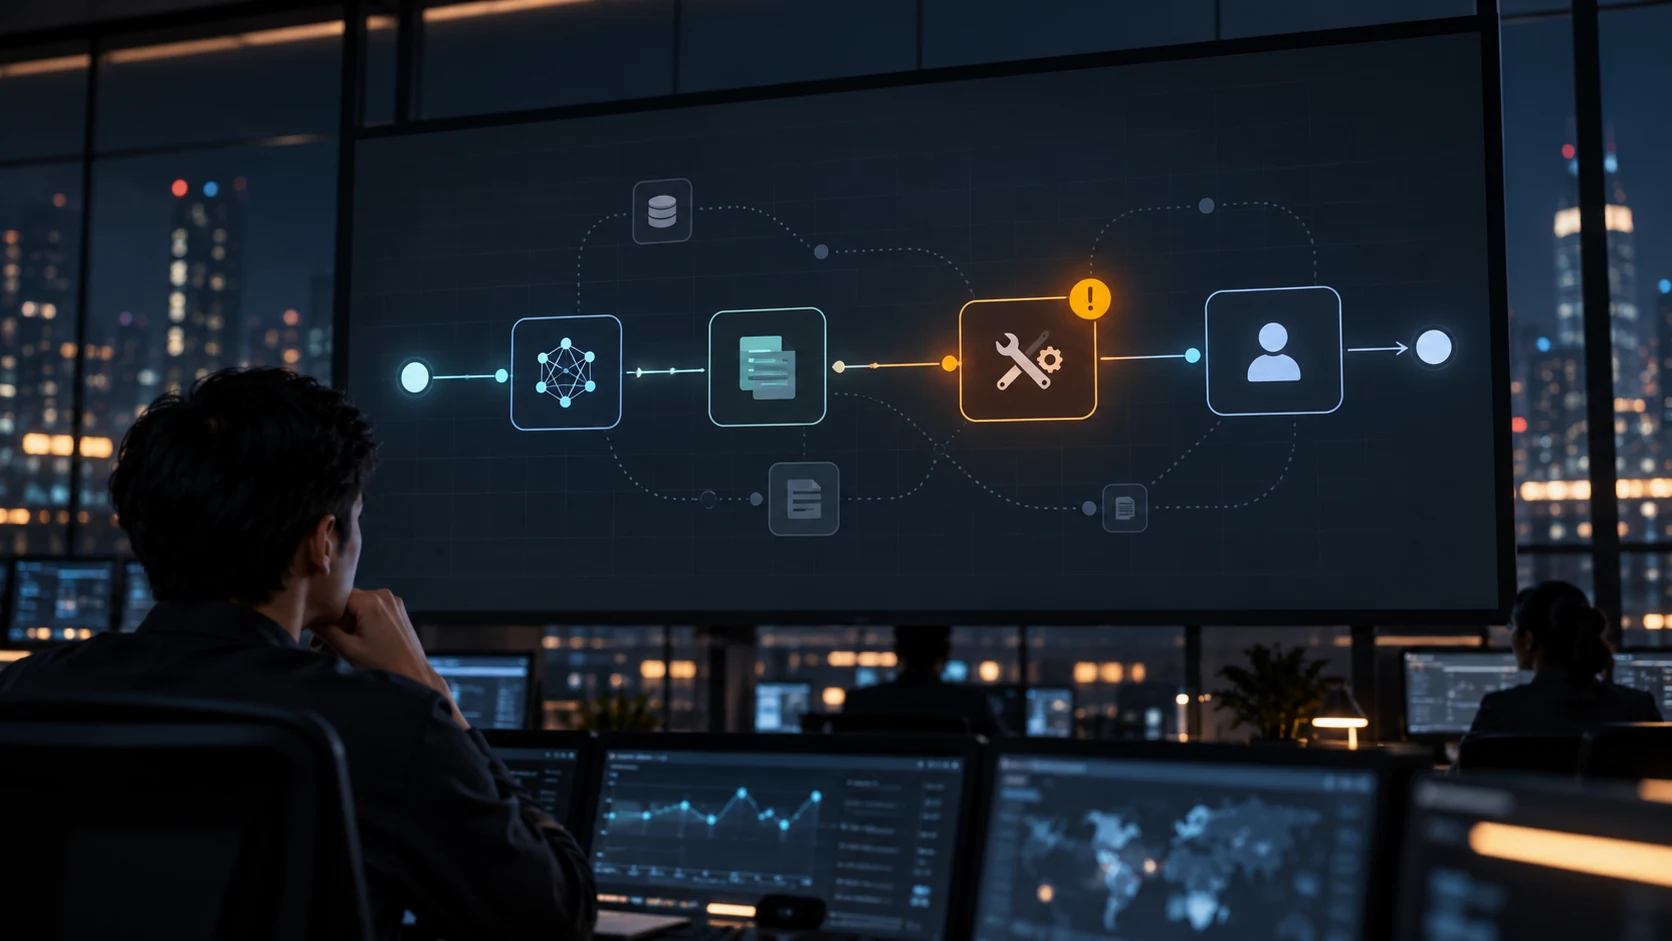
线上 Agent 出现异常时,聊天记录往往只保留用户请求和最终回复。业务人员看到“没有查到结果”,技术人员却不知道问题出在权限过滤、知识检索、工具超时还是生成过程。最终回复是任务的出口,不是足以排障的运行记录。这正是 Agent 可观测性要解决的问题:让团队能从一次结果回到它实际走过的环节。
按任务阶段保留证据
更有用的做法,是让每次任务都有一个可追踪的运行标识,并把关键环节按发生顺序串起来。收到请求时记录任务类型、时间和必要的用户授权上下文;检索知识时保留来源标识、版本和权限判定结果;调用工具时记录工具版本、校验结果、状态码、耗时和重试情况;任务结束时记录完成、失败、转人工或等待补充信息的原因。这样团队能回答“它经过了哪里”,而不必猜测模型为什么这么做。
用户请求、工具参数和业务结果可能包含个人信息、客户资料或内部经营数据。应按排障和审计的实际需要决定保存哪些字段、保存多久、谁可访问;可用任务标识、脱敏摘要和来源 ID 替代不必要的原文副本。模型内部的隐含推理文本也不是运维轨迹的必要组成,重点应放在可核对的输入输出、检索证据、工具状态和权限决策。
排障沿证据链走,并在安全环境复现
当一项任务没有按预期完成,轨迹应帮助团队沿着证据往下查:是不是拿错了资料版本?检索结果是否在权限过滤后变少?接口有没有超时,后端是否已经执行成功?重试会不会产生重复副作用?人工接手时有没有收到已完成步骤和失败原因?每个问题都指向不同的责任方,故障分类比笼统标成“模型不稳定”更能推动修复。
故障复现尤其要避免在生产环境里再次执行有副作用的操作。可以在测试环境中使用脱敏样本和固定版本回放检索与工具响应;如果要复查真实写入,应先查询当前业务状态,确认不会重复创建、发送或修改记录。一次成功回放也不等于普遍解决,仍要把原故障样本加入回归集,并检查相邻边界条件。
指标与告警要对应任务和处理人
运行看板应按任务类型拆分完成情况、失败原因、人工接管、工具可用性、响应耗时和单次成功任务成本。把所有场景混成一个平均值,常会让少数关键流程的退化不明显。监控阈值也应基于业务基线、用户承诺和风险确定;新场景尚无稳定基线时,先观察代表性样本,再逐步设置告警。
工具连续超时,可以通知接口负责人;新版本发布后特定任务失败增多,应让发布团队核对变更;某类知识持续被判为过期或无法引用,需要知识维护人处理。没有负责人、影响范围和下一步动作的告警,只会增加看板上的红点,并不会提高可用性。
让运行记录回到产品改进
可观测性最终要闭合到改进:保存问题样本和必要证据,定位到知识、权限、检索、工具或工作流,安排负责人修复,再用同类与边界场景回归。每次修复都记录所使用的版本和环境,避免把偶然成功当成问题已消失。这样运行数据才会变成维护能力,而不是不断堆积的日志。
宜天信达的企业智能体方案可结合现有业务系统、知识管理和权限体系设计运行记录与故障定位方式。实施时应和企业的信息安全、IT 运维及业务团队共同确定日志范围、保留规则、告警责任和回放环境,让排障能力与数据治理要求一起落地。
 本地大模型、部署选型
 企业 Agent、上线验收
 企业 Agent、MCP 接入
 本地模型、安装验收
 Agent 评测、研发回归