
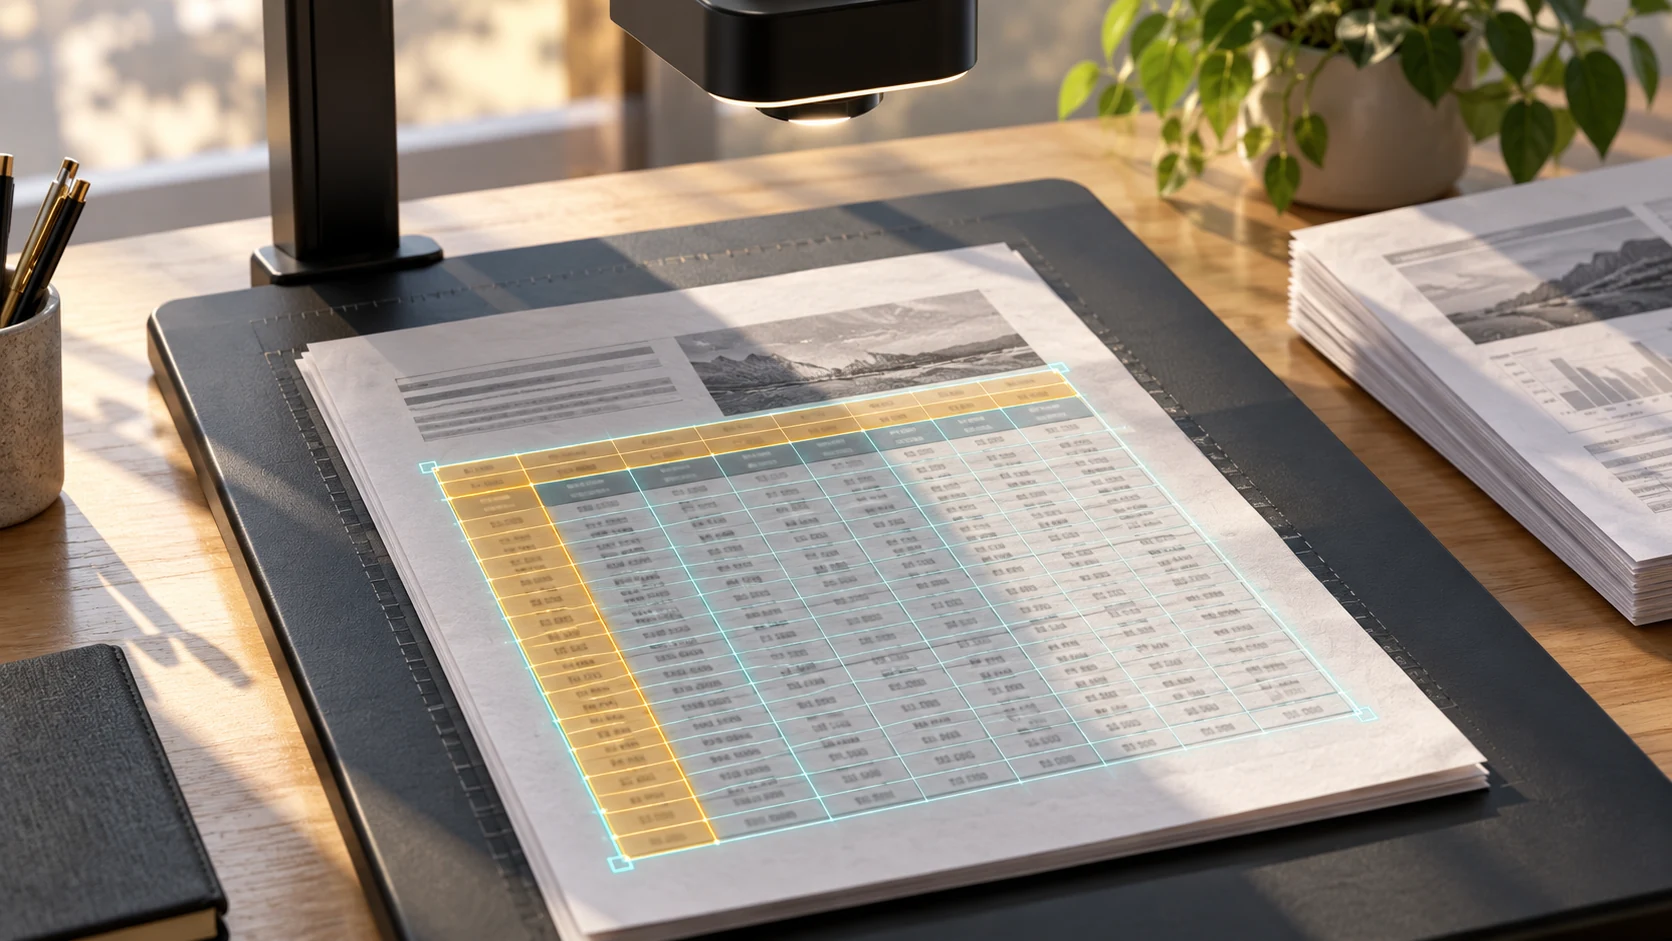
一份操作规程里,正文写着设备的通用检查办法,附表另列型号、温度范围和停机条件。员工问某型号在特定温度下能否继续运行,检索却只找回正文。文件明明已经上传,模型也没有报错,问题仍可能在最前面的解析环节:附表被抽成一串无标题的数字,型号与阈值失去了关系。
先判断是没有检索到,还是资料本身没读对
排查时把链路拆开看。先在解析结果里搜索问题中的型号或表头,确认文字是否存在;再查看这些文字是否还与正确行列关联;之后才检查切片里有没有保留足够上下文,最后核对检索结果是否命中。若解析文本已经缺列、串行或把扫描页留成空白,调提示词和换模型通常补不回丢掉的信息。
PDF 表格最容易丢的是表头与数据之间的关系。比如只保留“X2、80、停机”而没有“设备型号、温度上限、处理要求”,检索器能找到词,却无法判断数字各自代表什么。跨页表格还要留意续表的列名有没有带到下一页;合并单元格、脚注和表格前后的适用条件,也会改变一行数据的含义。
扫描件要先看页面是否真正可识别。倾斜、污渍、低分辨率、竖排文字、印章覆盖和细小脚注会让 OCR 出错;识别成功也不等于结构恢复成功。验收人员应对照原页查看数字、小数点、单位、否定词、条款编号和专有名词。对于安全阈值或合同条件,漏掉一个“不”字就可能把正确答案变成相反结论。
切片要把条件和结论留在一起
通过解析后再检查切片。按固定字数切开,可能把表名、列标题和数据行分到不同片段;只留表格行,又可能丢掉正文里说明的适用范围。可以为表格附上标题与列名,把每行转成包含字段名的结构化文本;对于扫描页面,保留页码、章节名和附近的说明段落。重点不是让片段越长越好,而是让一个片段本身足以解释字段含义。
切片还应保留能回到原文的定位信息:文件名称或稳定 ID、版本、生效时间、章节及页码。这样回答引用到“80”时,读者可以回到对应表格核对,而不会只看到一串难以追溯的片段。旧版与新版资料并存时,版本和有效状态要进入检索过滤条件;否则召回准确的旧答案,仍然是错误答案。
用问题样本验收解析链路
准备一组来自实际工作的问法,每道题标出应该依据的页、表头、行或条件。样本里既要有正文题,也要有扫描件题、跨页表格题和容易混淆的单位题。逐题检查解析文本、切片内容、命中片段和最终引用,记录错误从哪一层开始出现。不要只统计答案是否“看起来对”;应确认数字、适用对象和来源版本都一致。
抽样比例与验收门槛要根据资料风险定。普通知识问答可以先抽取不同格式和章节的代表样本;涉及安全、合规或金额的资料,应把关键表格和例外条件单独列为必检项。每次更换解析服务、OCR 参数或切片策略后,都用同一批样本回归。若来源文件本身扫描质量不足,先补扫或由业务人员校对,比让模型猜测更稳妥。
Microsoft 的文档布局资料展示了如何在解析时识别标题、段落、表格与页面结构,并将布局用于后续切块。它是实现思路的参考,不代表每种文档或工具都会得到相同效果;企业仍应拿自己的版式做样本验证。可以查看Document Layout 技能说明和按文档布局切片的指南。
如果解析结果已经正确,下一步可按知识库回答不准确的排查路径继续检查召回和排序;涉及资料来源、版本与责任人时,再参考企业知识库建设流程。这两类问题有时同时存在,但要先找到第一个发生偏差的环节。
 企业数据分析助手、AI 问数
 智能客服、客服运营
 企业 AI 工作流、流程自动化
 企业 Agent、效果评估
 企业微信、Agent 接入